Ley de Zipf
ests.visualizers.zipf(), ests.visualizers.zipf_theory()
Descripción
El gráfico de la ley de Zipf a partir de un contador de frecuencias de palabras.
Definición
La ley de Zipf (la ley de rango y frecuencia) es una regularidad empírica de la distribución de las frecuencias de las palabras en una lengua natural: si todas las palabras de una lengua, o de un texto lo bastante largo, se ordenan por frecuencia descendente, la frecuencia de la n-ésima palabra de la lista es aproximadamente inversamente proporcional a su número n, el rango de la palabra. La segunda palabra más frecuente aparece más o menos la mitad de veces que la primera, la tercera un tercio, y así sucesivamente.
Parámetros
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
counter |
Counter | - |
Contador de frecuencias de palabras |
num_words |
int | None |
Número de las palabras más frecuentes |
num_labels |
int | 10 |
Número de palabras etiquetadas en el gráfico |
log |
bool | True |
Usar una escala logarítmica |
show_theory |
bool | False |
Dibujar la ley de Zipf teórica |
alpha |
float | 1.5 |
Exponente α de la ley de Zipf teórica, mayor que cero |
show_fit |
bool | False |
Dibujar el ajuste de Zipf-Mandelbrot \(f(r) = C / (r + q)^s\) de fit_zipf_mandelbrot |
ax |
Axes | None |
Ejes de matplotlib para el gráfico; si no se dan, se crea una figura nueva |
La función devuelve los Axes con el gráfico; un num_words mayor que el número de tipos de palabra no alarga las curvas más allá de los datos, y un contador vacío lanza SourceError. zipf_theory(size, num_ranks, alpha, ax) dibuja solo la curva teórica, \(f(r) = size \cdot r^{-\alpha}\) para los rangos de 1 a num_ranks.
Ejemplo de uso
Los lemas de Marianela de Galdós de Project Gutenberg.
Ejemplo
Código:
from collections import Counter
from urllib.request import urlopen

from ests import WordsExtractor
from ests.visualizers import zipf

url = "https://www.gutenberg.org/cache/epub/17340/pg17340.txt"
text = urlopen(url).read().decode("utf-8")
text = text[text.index("\n", text.index("*** START OF")) : text.index("*** END OF")]
counts = Counter(WordsExtractor(use_lexemes=True, lowercase=True, filter_nums=True).extract(text))

ax = zipf(counts, num_labels=10, show_theory=True, alpha=1.0, show_fit=True)
ax.figure.savefig("zipf.png")
Resultado:
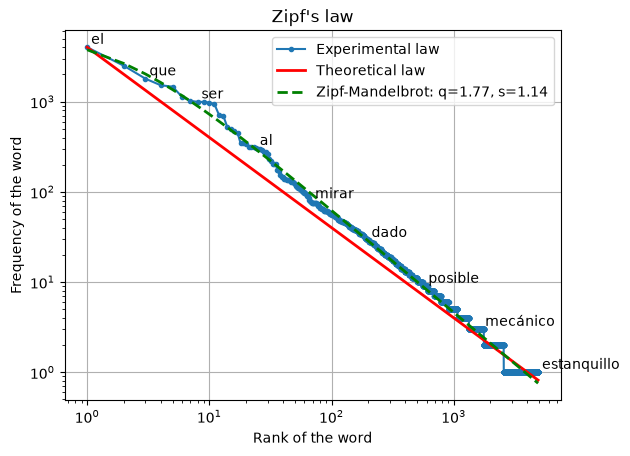
En ejes logarítmicos las frecuencias de los lemas caen a lo largo de una recta; el ajuste de Zipf-Mandelbrot, \(s = 1.14\) con un desplazamiento \(q = 1.77\), las sigue más de cerca en la cabeza de la lista que la ley teórica con \(\alpha = 1\).