Longitudes de las oraciones
sentence_lengths_plot(source, window=10, inset=True, ax=None, labels=None, sents_extractor=None, words_extractor=None)
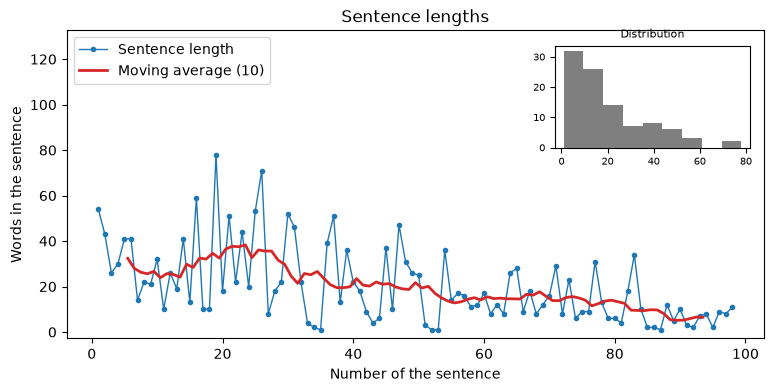
La curva de las longitudes de las oraciones, el ritmo de un texto: la longitud de cada oración en palabras, en orden, la media móvil sobre window oraciones y un recuadro con el histograma de las longitudes. Oraciones cortas y largas que se alternan son un signo editorial de un texto vivo; una curva plana, de uno monótono. La función recibe los ejes ax y devuelve Axes.
Las funciones son las del núcleo anyTS; para una cadena esTS pasa por defecto sus extractores del español, SentsExtractor y WordsExtractor, y los parámetros sents_extractor y words_extractor los sustituyen. Las etiquetas por defecto son las inglesas de VISUALIZER_LABELS en anyts.constants; labels sustituye cualquiera de ellas.
La curva de la segunda ventana de 2000 palabras de Niebla de Unamuno del corpus de literatura; una ventana se corta por palabras, así que empieza con el final de una oración:
from ests.corpus import split_windows
from ests.datasets import SpanishLiterature
from ests.visualizers import sentence_lengths_plot

sl = SpanishLiterature()
sl.download()
text = next(
    record["text"] for record in sl.get_records(author="unamuno") if record["title"] == "Niebla"
)
chapter = split_windows(text, 2000)[1]
sentence_lengths_plot(chapter, window=10)
Parámetros
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
source |
str / Doc / Iterable[int] |
- | Texto, objeto Doc o longitudes de las oraciones (una lista, un array de numpy, una Series) |
window |
int |
10 |
Ventana de la media móvil en oraciones |
inset |
bool |
True |
Mostrar el recuadro con el histograma |
ax |
Axes |
None |
Ejes para el gráfico |
labels |
dict[str, str] |
None |
Etiquetas sobre las de por defecto: title, xlabel, ylabel, length (la curva), average (una cadena de formato con window), distribution (el recuadro) |
sents_extractor |
SentsExtractor |
None |
Extractor de las oraciones de una cadena; por defecto, el extractor de oraciones de la biblioteca |
words_extractor |
WordsExtractor |
None |
Extractor de las palabras de una oración de una cadena; por defecto, el extractor de palabras de la biblioteca |
La fuente y los extractores lanzan los errores de sentence_lengths, y la falta de oraciones lanza SourceError; un window que no es un entero de al menos uno, unas etiquetas que merge_labels rechaza y un ax que no es un Axes de matplotlib lanzan ParameterError.
Longitudes de las oraciones
sentence_lengths(source, sents_extractor=None, words_extractor=None)
Las longitudes de las oraciones en palabras, en orden: una cadena se divide en oraciones con el extractor de oraciones y cada oración en palabras con el extractor de palabras; las oraciones de un Doc salen de sus límites y sus palabras de sus tokens, sin la puntuación ni los símbolos, mientras que un Doc sin límites o con límites parciales (has_sents) se cuenta como su texto, con los extractores. Las oraciones sin palabras se omiten. Las longitudes ya hechas (enteros no negativos en una secuencia o un iterador) se usan tal cual. Los argumentos son los de sentence_lengths_plot.
Excepciones:
SourceTypeError- un objeto que no es una cadena, unDoc, una secuencia ni un iterador, una tabla, un conjunto, un mapeo, bytes, una longitud que no es un entero, un extractor de otro tipo;SourceError- una longitud negativa, una cadena con un carácter sin forma UTF-8.
from ests.visualizers import sentence_lengths

sentence_lengths("El gato duerme. ¿Y el perro? —Come —dijo ella.")
sentence_lengths(chapter)[:5]
[3, 3, 3]
[1, 30, 41, 41, 14]