Gráficos de corpus
ests.visualizers.dispersion_plot(), ests.visualizers.keyness_plot(), ests.visualizers.collocation_network()
Descripción
Gráficos para las medidas de corpus: la dispersión léxica - dónde aparece una palabra en un texto -, un diagrama de las palabras clave que encuentra keyness y una red de las colocaciones que encuentra collocations. Las funciones de matplotlib reciben los ejes ax y devuelven Axes: sin ax se crea una figura nueva, con ellos el gráfico va a una rejilla propia; la red de colocaciones la construye graphviz y devuelve un Graph, como el árbol de palabras.
Dispersión léxica
Una fila por cada palabra de targets y una marca en la posición de cada una de sus apariciones en el texto, como dispersion_plot de NLTK y textplot_xray de quanteda. Las palabras se comparan tal cual: la caja y la lematización corresponden a WordsExtractor, y los lemas se buscan con use_lexemes=True.
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
words |
list[str] | - |
Palabras del texto en orden |
targets |
list[str] | - |
Palabras cuyas apariciones se muestran |
ax |
Axes | None |
Ejes para el gráfico |
Diagrama de palabras clave
Barras horizontales divergentes (textplot_keyness de quanteda): las palabras de positive a la derecha, las de negative - el resultado de keyness con positive=False - a la izquierda; la longitud de una barra es el valor absoluto del campo field (score, g2, log_ratio), así que el lado lo fija la lista y no el signo de la medida; top_n palabras por lado, y las palabras con un valor indefinido o infinito se omiten. Para la razón de momios (score de 0 a infinito, uno - momios iguales) indique log=True: se representa el valor absoluto de \(\log_2\) del valor, simétrico en torno a uno.
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
positive |
list[Keyword] | - |
Palabras clave positivas |
negative |
list[Keyword] | () |
Palabras clave negativas |
top_n |
int | 20 |
Número de palabras por lado |
labels |
tuple[str, str] | ("target corpus", "reference corpus") |
Etiquetas de la leyenda |
field |
str | score |
Campo de Keyword cuyos valores se representan |
log |
bool | False |
Representar \(\log_2\) del valor, para la razón de momios |
ax |
Axes | None |
Ejes para el gráfico |
Red de colocaciones
Un grafo no dirigido (textplot_network de quanteda): los nodos son las palabras con el tamaño de la letra según su frecuencia, las aristas son los pares con el grosor y la etiqueta según el valor de la medida; la disposición neato. Para dibujarlo hacen falta los ejecutables de Graphviz; en Jupyter el grafo se muestra solo, y graph.render("network", format="png") guarda un archivo.
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
collocations |
list[Collocation] | - |
Colocaciones |
top_n |
int | None |
Número de pares desde el principio de la lista; None - todos |
Ejemplo de uso
Marianela de Galdós y seis novelas de Project Gutenberg: Marianela, Misericordia y Torquemada en la hoguera frente a Niebla, Abel Sánchez y La tía Tula de Unamuno.
Ejemplo
Código:
from urllib.request import urlopen

from spacy.lang.es.stop_words import STOP_WORDS

from ests import WordsExtractor
from ests.corpus import collocations, keyness
from ests.visualizers import collocation_network, dispersion_plot, keyness_plot


def gutenberg(number):
    url = f"https://www.gutenberg.org/cache/epub/{number}/pg{number}.txt"
    text = urlopen(url).read().decode("utf-8")
    start = text.index("\n", text.index("*** START OF"))
    return text[start : text.index("*** END OF")]


# Dónde aparecen los personajes y los motivos de Marianela
marianela = gutenberg(17340)
words = WordsExtractor(lowercase=True).extract(marianela)
dispersion_plot(words, ["nela", "pablo", "florentina", "golfín", "ciego", "luz"])

# Palabras clave de Galdós frente a Unamuno, lemas sin palabras vacías
we = WordsExtractor(use_lexemes=True, lowercase=True, filter_nums=True, stopwords=STOP_WORDS)
galdos = [lemma for number in (17340, 21831, 15206) for lemma in we.extract(gutenberg(number))]
unamuno = [lemma for number in (49836, 44512, 44358) for lemma in we.extract(gutenberg(number))]
keyness_plot(
    keyness(galdos, unamuno, min_freq=5, top_n=10),
    keyness(galdos, unamuno, positive=False, min_freq=5, top_n=10),
    labels=("Galdós", "Unamuno"),
)

# Red de colocaciones de Marianela
graph = collocation_network(collocations(we.extract(marianela), window=3, min_freq=5, top_n=25))
graph.render("network", format="png")
Resultado:
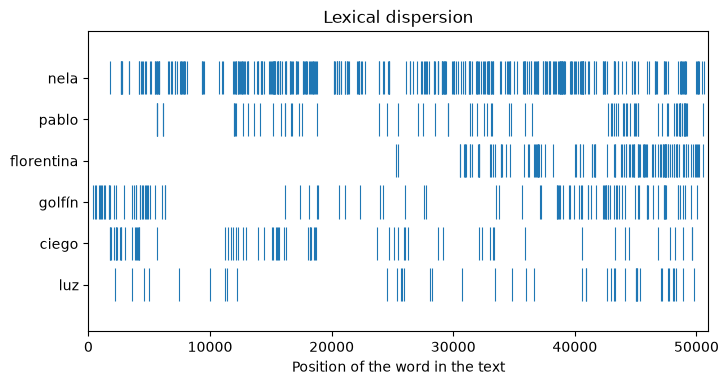
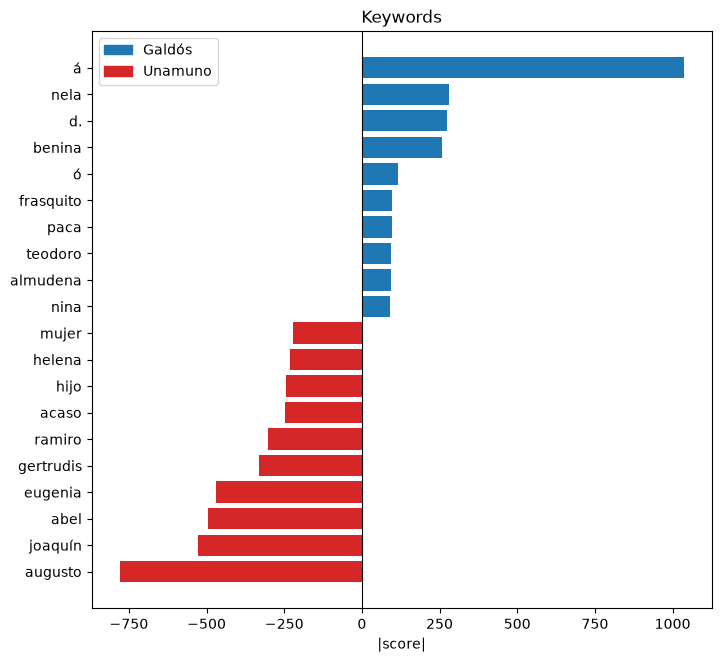
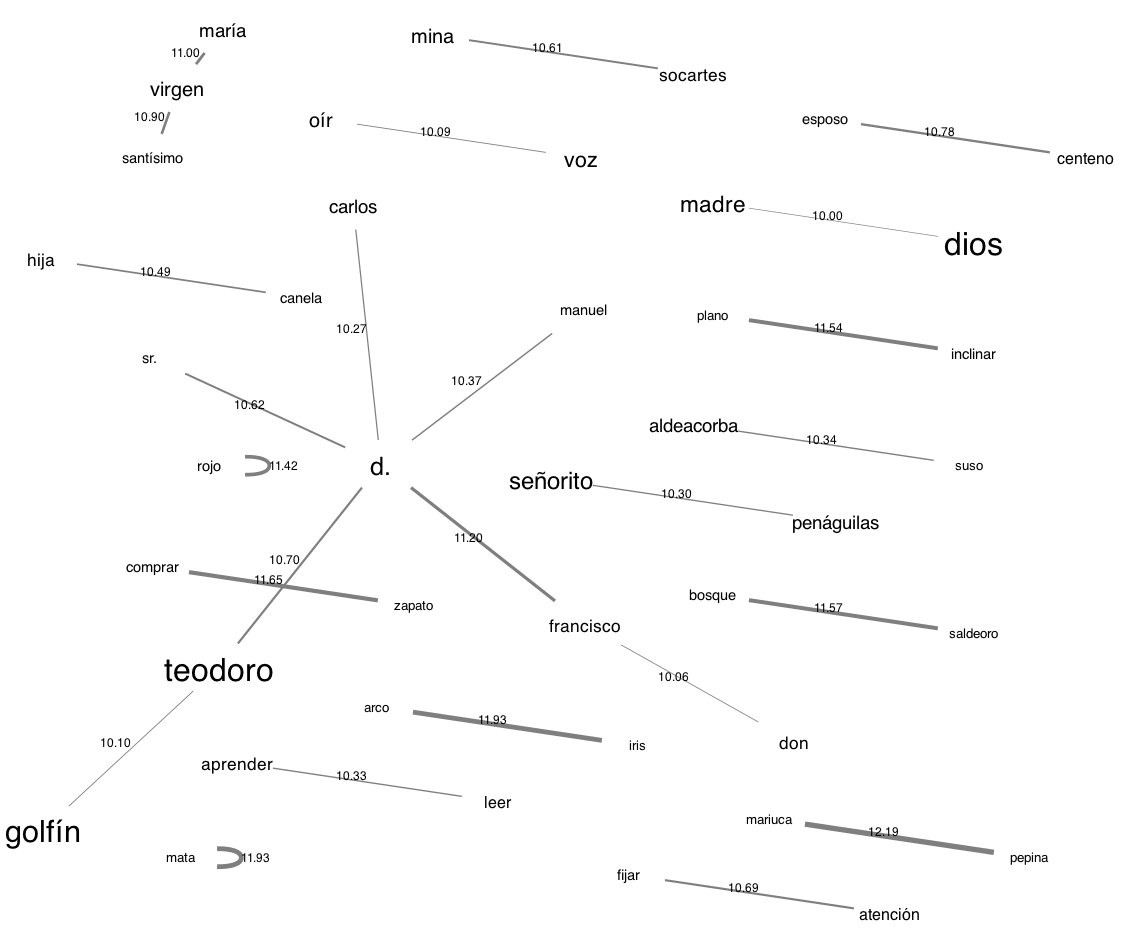
Nela recorre toda la novela, Florentina entra en su segunda mitad, y el doctor Golfín la abre y la cierra; la ceguera de Pablo (ciego) pertenece sobre todo a la primera mitad. Además de los nombres de los personajes, las palabras clave muestran la ortografía de las ediciones - á y ó con la tilde de la ortografía antigua en Galdós - y palabras de los temas de Unamuno: acaso, hijo, mujer. La red de colocaciones reúne los nombres y los lugares de Marianela en torno a d., el don abreviado: Teodoro Golfín, Aldeacorba de Suso, las minas de Socartes.