Huella literaria
fingerprinting(texts, segment_len=10, metric=None, x_size=800, y_size=600, cmap='viridis', ax=None, labels=None)
Visualización de la huella literaria (literature fingerprinting, Keim y Oelke 2007).
Cada texto se corta en segmentos de segment_len palabras con un paso deslizante de una décima parte del segmento, y para cada segmento se calcula una medida de diversidad léxica. Todos los segmentos tienen segment_len palabras, así que los valores son comparables: cuando el paso deja palabras tras el último segmento, uno más termina con el texto, y un texto que no es más largo que un segmento es un solo segmento.
Un texto es un bloque de cuadrados, sus segmentos fila a fila, de 8 filas de alto, o una sola columna con a lo sumo 8 segmentos; un bloque más ancho que el área de dibujo se parte en filas de esa anchura. Los bloques van de izquierda a derecha y pasan a la fila siguiente dentro de un área de 2 · x_size de ancho, que crece hacia abajo desde 2 · y_size cuando necesitan más altura. La barra de colores va del menor al mayor valor finito en todos los textos; los valores no definidos (nan en segmentos demasiado cortos para la medida) y las celdas vacías de un bloque son de un gris claro, distinto de cualquier valor, incluido el cero.
La función es la del núcleo anyTS; las medidas de diversidad léxica de esTS, funciones de una lista de palabras como calc_ttr o calc_simpson_index, sirven de metric. El título por defecto es el inglés de VISUALIZER_LABELS en anyts.constants; labels lo sustituye.
Las cinco primeras ventanas de 1000 palabras de seis novelas del corpus de literatura, tres de Galdós y tres de Unamuno, según el índice de Simpson:
from ests import WordsExtractor
from ests.corpus import split_windows
from ests.datasets import SpanishLiterature
from ests.diversity_stats import calc_simpson_index
from ests.visualizers import fingerprinting

sl = SpanishLiterature()
sl.download()
titles = (
    "Marianela",
    "Misericordia",
    "Torquemada en la hoguera",
    "Niebla",
    "Abel Sánchez",
    "La tía Tula",
)
novels = {
    record["title"]: record["text"]
    for author in ("galdos", "unamuno")
    for record in sl.get_records(author=author)
    if record["title"] in titles
}

we = WordsExtractor(lowercase=True)
texts = [
    we.extract(window) for title in titles for window in split_windows(novels[title], 1000)[:5]
]
fingerprinting(texts, segment_len=100, metric=calc_simpson_index, x_size=1000, y_size=330)
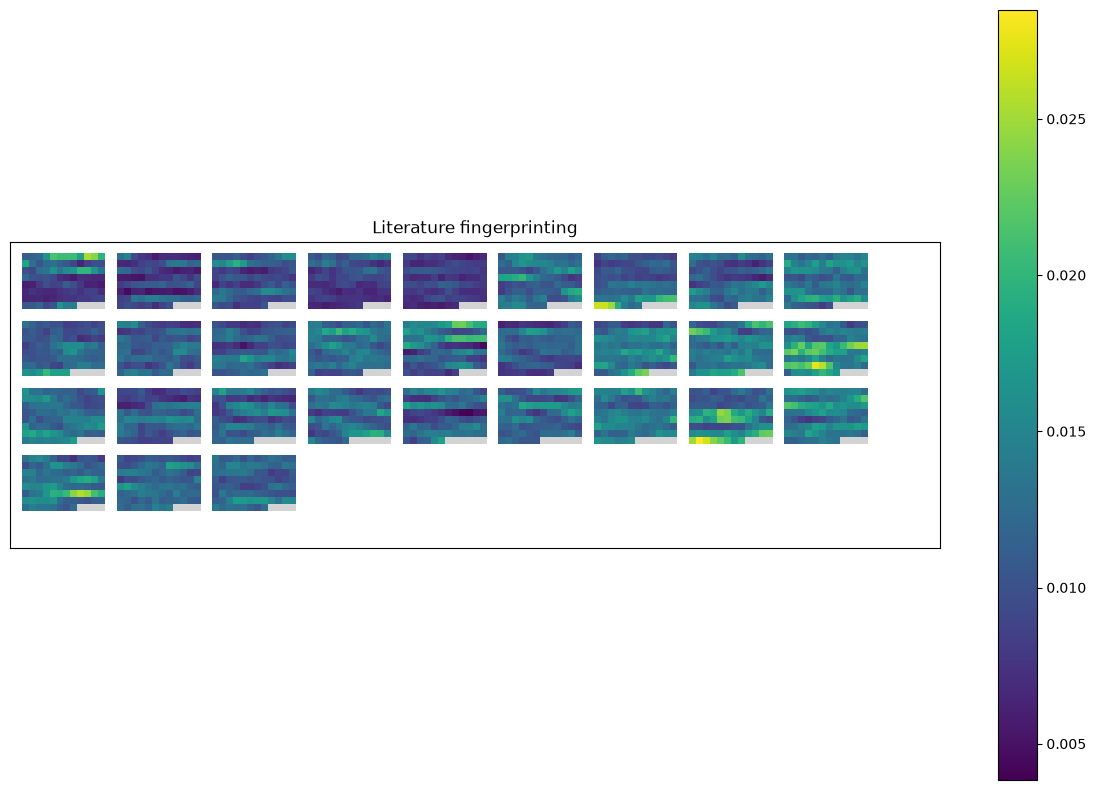
Los quince primeros bloques son de Galdós, los quince últimos de Unamuno. El índice de Simpson - la probabilidad de que dos palabras tomadas al azar sean la misma - es más bajo en Galdós, así que sus bloques son más oscuros y los de Unamuno, que repite más sus palabras, más verdes.
Parámetros
| Parámetro | Tipo | Por defecto | Descripción |
|---|---|---|---|
texts |
list[list[str]] |
- | Lista de listas de palabras |
segment_len |
int |
10 |
Tamaño de un segmento |
metric |
Callable |
None |
Función de una medida de diversidad léxica; calc_ttr por defecto |
x_size |
int |
800 |
Mitad de la anchura del área de dibujo, mayor que 25 (el margen entre los bloques) |
y_size |
int |
600 |
Mitad de la altura del área de dibujo, que crece cuando los bloques necesitan más |
cmap |
str |
'viridis' |
Mapa de colores |
ax |
Axes |
None |
Ejes de matplotlib para el gráfico; si no se dan, se crea una figura de 15×10 |
labels |
dict[str, str] |
None |
Etiquetas sobre las de por defecto: title |
La función devuelve los Axes con la visualización, con una relación de aspecto igual para que los cuadrados sigan siendo cuadrados; la figura es ax.figure. Unos textos que no son una lista de listas de cadenas y un metric que no es invocable lanzan SourceTypeError, una lista sin textos o un texto sin palabras SourceError. Un segment_len o un y_size que no es un entero mayor que cero, un x_size que no es un entero mayor que 25, un cmap desconocido, unas etiquetas que merge_labels rechaza y un ax que no es un Axes de matplotlib lanzan ParameterError.