Длины предложений
sentence_lengths_plot(source, window=10, inset=True, ax=None, labels=None, sents_extractor=None, words_extractor=None)
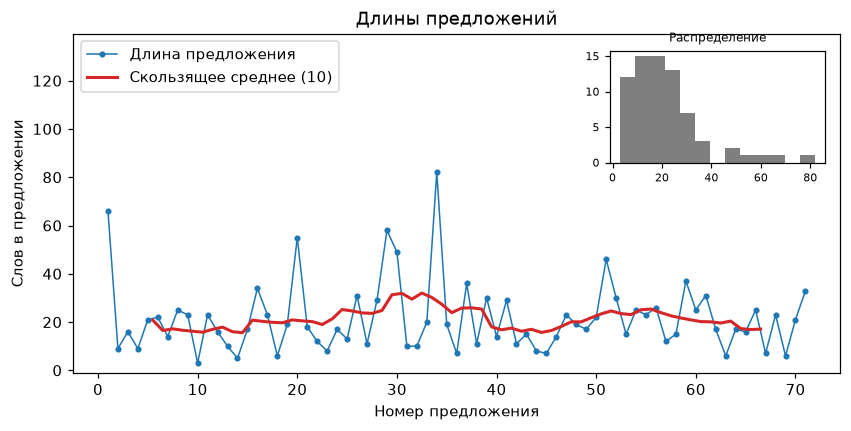
Кривая длин предложений - ритм текста: длина каждого предложения в словах по порядку, скользящее среднее по window предложениям и врезка с гистограммой длин. Чередование коротких и длинных предложений - редакторский признак живого текста, ровная кривая - монотонного. Функция принимает оси ax и возвращает Axes.
Это функции ядра anyTS; для строки ruTS по умолчанию передает русские SentsExtractor и WordsExtractor, параметры sents_extractor и words_extractor заменяют их. Подписи по умолчанию - русские из ruts.constants.VISUALIZER_LABELS; labels задает подписи поверх них.
Кривая первого текста набора данных StalinWorks:
from ruts.datasets import StalinWorks
from ruts.visualizers import sentence_lengths_plot

text = next(StalinWorks().get_texts(limit=1))
sentence_lengths_plot(text, window=10)
Параметры
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
source |
str / Doc / Iterable[int] |
- | Текст, объект Doc или длины предложений (список, массив numpy, Series) |
window |
int |
10 |
Окно скользящего среднего в предложениях |
inset |
bool |
True |
Показывать врезку с гистограммой |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel, length (кривая), average (строка формата с window), distribution (врезка) |
sents_extractor |
SentsExtractor |
None |
Инструмент для извлечения предложений строки; по умолчанию экстрактор предложений библиотеки |
words_extractor |
WordsExtractor |
None |
Инструмент для извлечения слов предложения строки; по умолчанию экстрактор слов библиотеки |
Источник и экстракторы дают ошибки sentence_lengths, а отсутствие предложений - SourceError; window, который не целое число не меньше единицы, подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Длины предложений
sentence_lengths(source, sents_extractor=None, words_extractor=None)
Длины предложений в словах по порядку: строка делится на предложения экстрактором предложений, каждое предложение - на слова экстрактором слов; предложения Doc берутся из его границ, а слова - из его токенов без знаков препинания и символов, причем части дефисного слова склеиваются (во-первых - одно слово); Doc без границ или с частичными границами (has_sents) считается как его текст, экстракторами. Предложения без слов пропускаются. Готовые длины (неотрицательные целые числа в последовательности или итераторе) используются как есть. Аргументы - те же, что у sentence_lengths_plot.
Таблица, множество, словарь, байты, длина, которая не целое число, и экстрактор другого типа дают SourceTypeError, отрицательная длина - SourceError.
from ruts.visualizers import sentence_lengths

sentence_lengths("Кот спит. Где пёс? - Ест, - сказала она.")
sentence_lengths(text)[:5]
[2, 2, 3]
[66, 9, 16, 9, 21]