Рост словаря и спектр частот
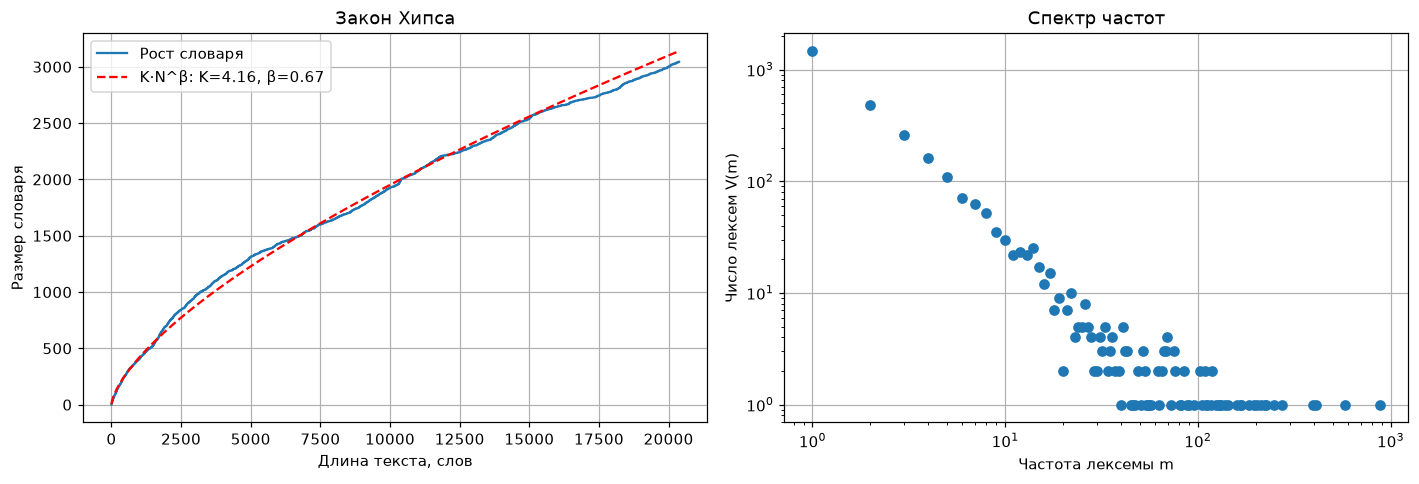
Два графика о распределении слов текста, дополняющие закон Ципфа: рост словаря с длиной текста по закону Хипса и спектр частот - сколько лексем встречается ровно один, два, три раза. Оба графика есть в zipfR (plot.vgc, plot.spc). Функции принимают оси ax и возвращают Axes.
Это функции ядра anyTS с русскими подписями из ruts.constants.VISUALIZER_LABELS по умолчанию; labels задает подписи поверх них. Подгонка закона Хипса описана в fit_heaps, спектр - в calc_frequency_spectrum.
Закон Хипса
heaps_plot(words, ax=None, labels=None)
Размер словаря \(V\) после каждого слова текста и кривая подгонки \(V(N) = K \cdot N^{\beta}\) по fit_heaps с параметрами в легенде; кривая зависит от порядка слов.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
words |
list[str] |
- | Слова текста по порядку |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel, growth (кривая), fit (строка формата с k и beta) |
Слова, которые не список строк, дают SourceTypeError, меньше двух слов - SourceError; подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Спектр частот
frequency_spectrum_plot(words, ax=None, labels=None)
Число лексем \(V(m)\), встретившихся ровно \(m\) раз (calc_frequency_spectrum), в логарифмических координатах; левый край - гапаксы. По спектру считаются меры разнообразия Юла, Сишела, Мишеа и Оноре, а его форма показывает, насколько словарь текста далек от исчерпания.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
words |
list[str] |
- | Слова текста |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel |
Слова, которые не список строк, дают SourceTypeError, отсутствие слов - SourceError; подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Графики по 12 текстам набора данных StalinWorks:
import matplotlib.pyplot as plt

from ruts import WordsExtractor
from ruts.datasets import StalinWorks
from ruts.visualizers import frequency_spectrum_plot, heaps_plot

we = WordsExtractor(use_lexemes=True, lowercase=True, filter_nums=True)
lemmas = [lemma for text in StalinWorks().get_texts(limit=12) for lemma in we.extract(text)]

fig, (left, right) = plt.subplots(1, 2, figsize=(13, 4.5))
heaps_plot(lemmas, ax=left)
frequency_spectrum_plot(lemmas, ax=right)