Стилометрические графики
Графики к стилометрии: дендрограмма, многомерное шкалирование и гистограммы расстояний внутри и между авторами по матрице расстояний delta, диаграмма главных компонент по частотам самых частых слов, расстояния скользящей дельты вдоль текста, сегменты корпусов по маркерам Zeta и кривые Менденхолла нескольких текстов - набор, которым в stylo исследуют авторство текстов. Функции принимают оси ax и возвращают Axes.
Это функции ядра anyTS с русскими подписями из ruts.constants.VISUALIZER_LABELS по умолчанию; labels задает подписи поверх них. Частоты для главных компонент дает frequency_table, расстояния вдоль текста - rolling_delta, сегменты - zeta_segments, кривые - mendenhall_curve.
Дендрограмма
dendrogram_plot(distances, method='ward', ax=None, labels=None)
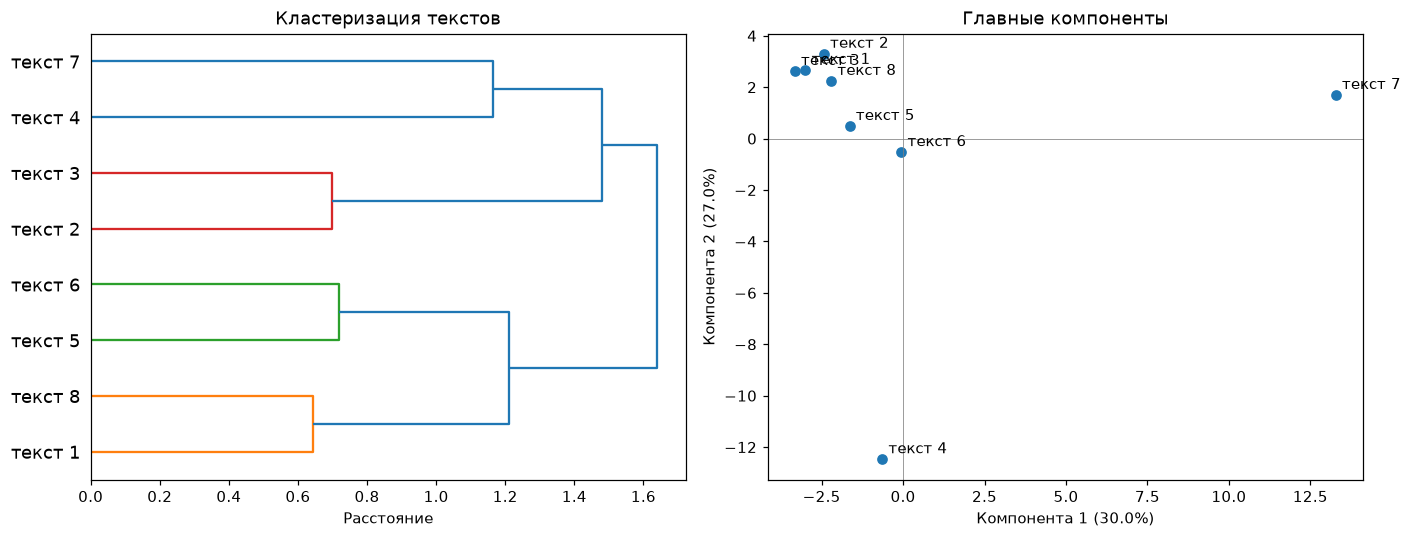
Иерархическая кластеризация scipy.cluster.hierarchy по матрице расстояний между текстами, по умолчанию методом Уорда, как у Evert и др. (2015); листья подписываются по индексу матрицы. Столбцы берутся в порядке строк.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
distances |
DataFrame |
- | Симметричная матрица расстояний с именами текстов в строках и столбцах, в любом порядке |
method |
str |
'ward' |
Метод объединения кластеров scipy.cluster.hierarchy.linkage: single, complete, average, weighted, centroid, median или ward |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel |
Матрица, в столбцах которой другие тексты, чем в строках, меньше двух текстов, бесконечное или отрицательное расстояние, асимметрия или расстояние на диагонали дают SourceError до создания фигуры. Расстояния, которые не DataFrame чисел, дают SourceTypeError; неизвестный method, подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Главные компоненты
pca_plot(corpus, n_mfw=100, culling=0.0, ax=None, labels=None)
Метод главных компонент по z-оценкам относительных частот самых частых единиц (frequency_table, z_scores): тексты на плоскости двух первых компонент с их именами, доли объясненной дисперсии - в подписях осей.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
corpus |
dict[str, list[str]] |
- | Единицы текстов по именам текстов |
n_mfw |
int |
100 |
Число самых частых единиц; None - все |
culling |
float |
0.0 |
Наименьшая доля текстов, в которых встречается единица |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel и ylabel (строки формата с объясненной долей share) |
Корпус, n_mfw и culling дают ошибки frequency_table, а меньше трех текстов - SourceError; подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Многомерное шкалирование
mds_plot(distances, ax=None, labels=None)
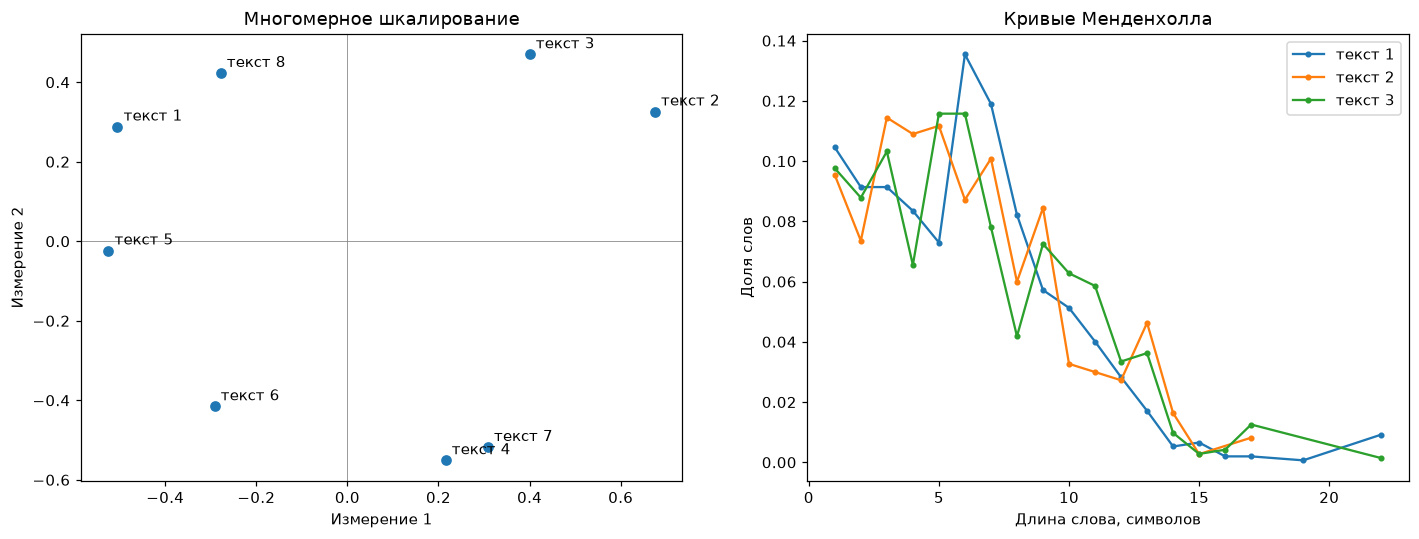
Классическое многомерное шкалирование (Torgerson 1952) по любой матрице расстояний: два главных собственных вектора дважды центрированной матрицы квадратов расстояний, так что расстояния между точками приближают расстояния матрицы. Столбцы берутся в порядке строк.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
distances |
DataFrame |
- | Симметричная матрица расстояний с именами текстов в строках и столбцах, в любом порядке |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel |
Матрица, в столбцах которой другие тексты, чем в строках, меньше двух текстов, бесконечное или отрицательное расстояние, асимметрия или расстояние на диагонали дают SourceError до создания фигуры. Расстояния, которые не DataFrame чисел, дают SourceTypeError; подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Расстояния внутри и между авторами
delta_histogram_plot(distances, authors, bins=20, ax=None, labels=None)
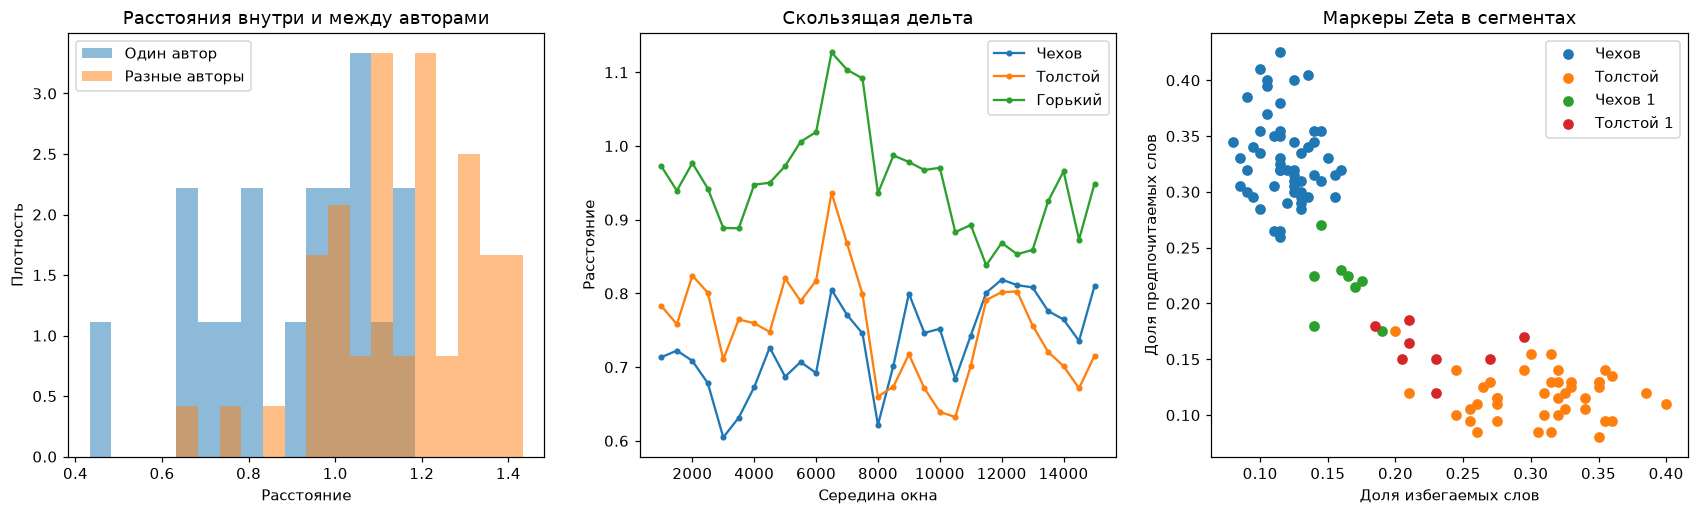
Гистограммы расстояний пар текстов одного автора и пар текстов разных авторов - плотности по общим интервалам, так что группы разного размера сравнимы. Чем меньше гистограммы перекрываются, тем лучше расстояния различают авторов - проверка числа единиц и варианта дельты на текстах известных авторов. Столбцы берутся в порядке строк.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
distances |
DataFrame |
- | Симметричная матрица расстояний с именами текстов в строках и столбцах, в любом порядке |
authors |
dict[str, str] |
- | Авторы текстов по именам текстов |
bins |
int |
20 |
Число интервалов, не больше 1000 |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel и легенда within, between |
Матрица дает ошибки dendrogram_plot; авторы, которые не словарь, дают SourceTypeError, а текст без автора, ни одной пары текстов одного автора или все тексты одного автора - SourceError. bins, который не целое число от 1 до 1000, подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Скользящая дельта
rolling_delta_plot(distances, ax=None, labels=None)
Расстояния rolling_delta - линия для каждого эталонного текста по серединам окон: самая нижняя линия - ближайший эталон части текста, а там, где линии пересекаются, меняется стиль.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
distances |
DataFrame |
- | Расстояния rolling_delta: окна по позиции их середины в строках, эталонные тексты в столбцах |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel |
Расстояния, которые не DataFrame чисел с числами в индексе, дают SourceTypeError; отсутствие окон или эталонных текстов, позиция, которая не конечное число, и бесконечное или отрицательное расстояние дают SourceError до создания фигуры. Подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Диаграмма рассеяния Zeta
zeta_scatter_plot(segments, ax=None, labels=None)
Сегменты zeta_segments на плоскости долей избегаемых слов (горизонтальная ось) и предпочитаемых слов (вертикальная ось), у каждого корпуса свой цвет, как на графике oppose в stylo.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
segments |
DataFrame |
- | Сегменты zeta_segments со столбцами corpus, preferred и avoided |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel |
Сегменты, которые не DataFrame, или доли, которые не числа, дают SourceTypeError; отсутствующий или повторяющийся столбец, отсутствие сегментов и доля, которая не конечное число, дают SourceError до создания фигуры. Сегменты без имени корпуса (NaN) рисуются как отдельный корпус. Подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Кривые Менденхолла
mendenhall_plot(corpus, ax=None, labels=None)
Доли слов по длине в символах (mendenhall_curve) для каждого текста на одном графике; длина, которой нет ни у одного слова, рисуется в нуле.
| Параметр | Тип | По умолчанию | Описание |
|---|---|---|---|
corpus |
dict[str, list[str]] |
- | Слова текстов по именам текстов |
ax |
Axes |
None |
Оси для графика |
labels |
dict[str, str] |
None |
Подписи поверх подписей по умолчанию: title, xlabel, ylabel |
Корпус, который не словарь списков строк, дает SourceTypeError, отсутствие текстов или текст без слов - SourceError; подписи, которые отвергает merge_labels, и ax, который не Axes matplotlib, дают ParameterError.
Графики по 8 текстам набора данных StalinWorks:
import matplotlib.pyplot as plt

from ruts import WordsExtractor
from ruts.corpus import delta
from ruts.datasets import StalinWorks
from ruts.visualizers import dendrogram_plot, mds_plot, mendenhall_plot, pca_plot

we = WordsExtractor(use_lexemes=True, lowercase=True, filter_nums=True)
texts = StalinWorks().get_texts(limit=8)
corpus = {f"текст {i + 1}": we.extract(text) for i, text in enumerate(texts)}
distances = delta(corpus, n_mfw=100, variant="cosine")

fig, (left, right) = plt.subplots(1, 2, figsize=(13, 5))
dendrogram_plot(distances, ax=left)
pca_plot(corpus, n_mfw=100, ax=right)

fig, (left, right) = plt.subplots(1, 2, figsize=(13, 5))
mds_plot(distances, ax=left)
mendenhall_plot({name: corpus[name] for name in list(corpus)[:3]}, ax=right)
Графики по 12 произведениям Чехова, Толстого и Горького жанра prose набора данных RussianLiterature: расстояния между всеми произведениями, скользящая дельта по первому произведению Чехова, за которым следует первое произведение Толстого, с эталонами из остальных трех произведений каждого автора и сегменты по маркерам Zeta Чехова против Толстого:
from ruts.corpus import rolling_delta, zeta, zeta_segments
from ruts.datasets import RussianLiterature
from ruts.visualizers import delta_histogram_plot, rolling_delta_plot, zeta_scatter_plot

names = ("Чехов", "Толстой", "Горький")
rl = RussianLiterature()
corpus, authors = {}, {}
for author in names:
    texts = rl.get_texts(genre="prose", author=author, min_len=40000, max_len=200000, limit=4)
    for i, text in enumerate(texts, 1):
        corpus[f"{author} {i}"] = we.extract(text)
        authors[f"{author} {i}"] = author
known = {author: [corpus[f"{author} {i}"] for i in (2, 3, 4)] for author in names}
reference = {author: [word for words in known[author] for word in words] for author in names}
scores = zeta(known["Чехов"], known["Толстой"], segment_size=1000)
preferred = [score.word for score in scores[:200]]
avoided = [score.word for score in scores[-200:]]
corpora = {
    "Чехов": known["Чехов"],
    "Толстой": known["Толстой"],
    "Чехов 1": corpus["Чехов 1"],
    "Толстой 1": corpus["Толстой 1"],
}

fig, axes = plt.subplots(1, 3, figsize=(19, 5))
delta_histogram_plot(delta(corpus, n_mfw=100, variant="cosine"), authors, ax=axes[0])
rolling_delta_plot(
    rolling_delta(reference, corpus["Чехов 1"] + corpus["Толстой 1"], window=2000, step=500),
    ax=axes[1],
)
zeta_scatter_plot(zeta_segments(corpora, preferred, avoided, segment_size=1000), ax=axes[2])